Мониторинг внешней зависимости соединяет два сигнала: официальный статус поставщика и собственную проверку клиентского пути. Статус провайдера помогает понять масштаб инцидента, но зелёный индикатор не доказывает, что ваш DNS, токен, регион или конкретный API-запрос работают.
Один пользовательский запрос может зависеть от CDN, почты, платёжного шлюза и облачной базы. Когда заказ не завершается, открытие страницы статуса провайдера полезно, но её общий индикатор охватывает множество клиентов и регионов. Нужен отдельный тест того пути, который проходит ваш продукт. Для примера мы считали публичные status API Cloudflare, Twilio и GitHub и сохранили ответы; это снимок, а не статистика их надёжности.
Как работает связка сигналов
Клиент → ваш сайт → внешний API → подтверждение операции
           │              │
           ├─ свой тест ────┘
           └─ лента статуса поставщика
Решение: собственный сбой + статус поставщика + локальные логи
Сначала определите пользовательскую операцию: отправка одноразового письма, создание платёжной сессии или получение ответа API. Затем проверьте её безопасным тестовым запросом. Отдельно подпишитесь на официальный статус сервиса или считывайте его API. При тревоге сравните время, регион и компонент. Совпадение повышает вероятность внешнего инцидента, расхождение указывает на локальный путь, лимит, учётные данные или ещё не объявленный сбой поставщика.
Не привязывайте внутреннюю тревогу только к зелёному/красному значку провайдера. Status page отражает опубликованное сообщение, которое может запаздывать. Кроме того, агрегатный статус часто не показывает ошибку одного проекта, аккаунта или региона. Если ваш тест падает, он остаётся основанием для расследования независимо от цвета страницы.
Составьте карту зависимостей
Начните с пяти ключевых пользовательских операций и выпишите внешние сервисы на каждом шаге. Для каждой связи зафиксируйте владельца, компонент, регион, режим деградации, путь обхода и ссылку на официальный источник статуса. Такая карта особенно полезна при дежурстве: она превращает «сайт тормозит» в конкретный вопрос к CDN, API, почте или вашему коду.
| Зависимость | Собственная проверка | Публичный статус | Решение при сбое |
|---|---|---|---|
| CDN | Запрос критичного ресурса из нужного региона | Компонент и регион CDN | Проверить origin и маршрут |
| Почтовый API | Тестовая отправка с ограничением частоты | API и очередь поставщика | Поставить событие в очередь повтора |
| Платежи | Тестовая сессия и подтверждение заказа | Шлюз и вебхуки | Не помечать заказ оплаченным заранее |
| Хранилище | Чтение безопасного тестового объекта | Регион хранилища | Переключить режим деградации |
Для SMS проверка должна измерять задержку от запроса к Twilio до получения сообщения на тестовый номер; успешный ответ API означает лишь приём задачи. Ограничьте частоту и стоимость, а номер исключите из клиентских рассылок. Для OAuth проверяйте не только страницу входа поставщика, но и обмен тестового кода на токен в разрешённом тестовом приложении. Истёкший секрет клиента или неверный redirect URI затронет только вас и не появится на общей странице статуса.
Как получить публичный статус
У ряда поставщиков есть Statuspage API с JSON-эндпоинтом /api/v2/status.json. Он возвращает агрегатный индикатор и описание. Мы получили ответы HTTP 200 от публичных API трёх сервисов; в момент снимка у Cloudflare и Twilio был индикатор minor, у GitHub — none. Эти значения меняются и не описывают качество конкретного запроса клиента.
curl -fsS https://www.githubstatus.com/api/v2/status.json
# HTTP 200; status.indicator: none (локальный снимок 14.11.2026)
curl -fsS https://www.cloudflarestatus.com/api/v2/status.json
# HTTP 200; status.indicator: minor (тот же снимок)
Для автоматизации проверяйте также доступность самого status API. При его ошибке состояние поставщика становится неизвестным, а не «работает». Если провайдер даёт RSS, email или webhook, выберите канал с устойчивым хранением событий. Записывайте ID инцидента и время обновления, чтобы не отправлять одну и ту же тревогу при каждом опросе.
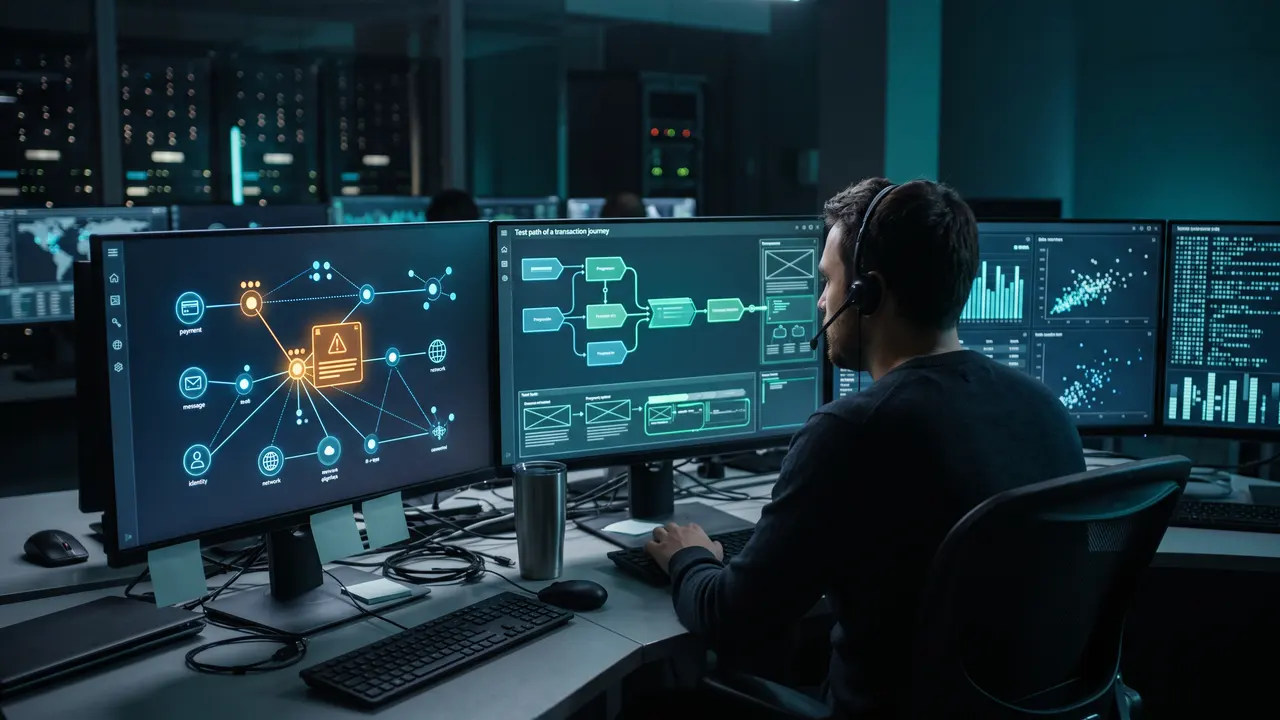
Два экрана показывают публичный статус и клиентскую транзакцию
Создайте в мониторах enterno.io проверку своего публичного endpoint или в синтетиках пройдите важное действие. Поставьте порог ошибки на ваш сервис, а сообщения о провайдере используйте как контекст. При несовпадении сигналов исследуйте API-ответ, внешнюю доступность и TLS. Для закрытых сервисов подойдёт локальный probe с heartbeat.
Уведомление должно отвечать на три вопроса: какая клиентская операция сломалась, где это измерено и что говорит поставщик. Отдельно укажите ссылку на runbook. Если внешний инцидент подтверждён, не выключайте свой монитор: именно он покажет, когда ваш продукт восстановился. Статус провайдера может стать зелёным до очистки вашей очереди.
Решения и компромиссы
| Подход | Что обнаруживает | Слепая зона |
|---|---|---|
| Только status page | Опубликованный массовый инцидент | Ошибка одного аккаунта или запроса |
| Только свой API-тест | Сбой вашего пути | Причина и масштаб вне вашей системы |
| Оба сигнала | Симптом и внешний контекст | Требует маршрутизации и контроля шума |
Собственный тест должен быть безопасным и дешёвым. Не отправляйте реальные письма клиентам каждую минуту и не создавайте настоящие платежи. Отдельный sandbox, тестовый адрес и ограничение частоты позволяют измерять путь без побочных действий. Для оплаты учитывайте серверный callback и состояние заказа.
Пример разбора: оплата проходит у провайдера, но заказ висит
Предположим, монитор браузера создал тестовый заказ и дошёл до платёжной страницы. Страница статуса провайдера зелёная, а заказ через 2 минуты всё ещё pending. Сначала найдите идентификатор тестовой операции и проверьте, была ли создана платёжная сессия. Затем ищите webhook с тем же ID. Если webhook не приходил, проверьте настройки endpoint, TLS, очередь доставки и события у провайдера. Если приходил, исследуйте проверку подписи и запись в базу. Общий статус провайдера здесь почти не помогает: проблема может быть только у вашего webhook.
Другой случай: одновременно падают ваши тестовые операции в двух регионах и официальный статус показывает сбой платёжного API. Тогда сообщение провайдера ускоряет классификацию, но собственные проверки остаются включёнными. После восстановления его API ваш обработчик может ещё обрабатывать накопившуюся очередь. Считать инцидент закрытым следует по вашему успешному заказу, а не по обновлённому баннеру поставщика.
Похожая логика действует для SMS. API может принять сообщение с HTTP 202, а доставка на тестовый номер не состоится из-за маршрута оператора или ограничения аккаунта. Поэтому проверяйте конечное событие доставки, если поставщик его предоставляет, и используйте выделенный номер. Для OAuth результатом считается полученный и проверенный токен тестового приложения, а не загрузившаяся страница авторизации. Не сохраняйте полученный токен в скриншотах или общих логах.
Как проектировать проверку без лишних побочных эффектов
Каждый синтетический запрос должен иметь отдельный тестовый объект и ограничение частоты. Для CDN запросите неизменяемый статический файл и проверьте его контрольный признак. Для почты используйте ящик, который не пересылает сообщения клиентам. Для SMS — тестовый номер или песочницу провайдера. Для оплаты — только sandbox и тестовую карту, затем серверное подтверждение заказа. Если провайдер не даёт безопасного способа выполнить операцию, проверяйте ближайшую доступную стадию и явно называйте ограничение.
Установите бюджет на тест. Допустим, проверка SMS стоит небольшую сумму за каждую отправку: минутный интервал создаст 1440 сообщений в сутки на одну точку. При трёх регионах их уже 4320. Такая частота может исчерпать лимит или исказить расходы, хотя задача мониторинга решается более редкими запросами. Расчёт числа запусков добавьте в бриф до включения проверки. Для бесплатных API тоже учитывайте квоты и rate limit.
Следите за сохранностью тестовых данных. Платёжные идентификаторы, телефонные номера и OAuth-токены не должны попасть в публичные логи или отчёты. В алерт достаточно включить безопасный ID проверки, тип ошибки, время UTC и ссылку на внутренний журнал. Если статус API провайдера возвращает подробности инцидента, цитируйте ссылку и компонент, а не копируйте огромный текст в каждый алерт.
Группировка тревог и восстановление
Свяжите зависимости с пользовательскими действиями. Один массовый сбой CDN может вызвать десятки проверок с одинаковым симптомом; сгруппируйте их по компоненту и времени, но сохраните перечень затронутых операций. Обратный случай тоже возможен: только один регион или клиентский тариф ломается из-за локальной конфигурации. Если всё свернуть в одну «общую» тревогу, команда потеряет границы воздействия.
Записывайте момент первого неуспеха собственного теста и момент первого сообщения поставщика. Разница между ними помогает понять задержку публикации статуса, но по одному инциденту нельзя делать статистический вывод. При восстановлении требуйте хотя бы один полный успешный прогон пользовательской операции после исправления, а для асинхронных операций — завершения очереди. Сообщение «resolved» у поставщика является полезным контекстом, но не проверкой вашего продукта.
Раз в квартал пересматривайте карту: внешние API меняют домены, компонентные имена и способы уведомления. Старый status URL может начать перенаправлять или отдавать ошибку, а ваш парсер — незаметно считать пустой ответ зелёным. Отдельно проверяйте, что парсер распознаёт неизвестное состояние и сохраняет дату последнего обновления. Тогда отсутствие данных будет видно дежурному, а не скрыто за ложным «всё хорошо».
Наш снимок содержит ровно 3 поставщика и 3 ответа HTTP 200: у 2 индикатор minor, у 1 — none. Это описание одного запроса к каждому API, а не процент отказов. Чтобы оценить надёжность, потребовались бы длительное наблюдение, одинаковая частота измерений, учёт регионов и определение того, что считается клиентским сбоем. Этих данных в нашем примере нет. Проверять один и тот же endpoint каждую минуту из одного региона также недостаточно: это выборка одного сетевого маршрута. Для оценки собственного сервиса понадобятся независимые точки наблюдения и запись фактического результата каждой проверяемой пользовательской операции.
Как сделан материал
14 ноября 2026 года локальный скрипт запросил публичные JSON API Cloudflare, Twilio и GitHub и сохранил HTTP-коды, индикаторы и время выборки. Это три наблюдения в один момент времени, без вывода о доступности реальных клиентских маршрутов. Схема сигналов и рекомендуемые действия сверены с официальными API и руководством Google SRE по мониторингу распределённых систем.
Частые вопросы
Можно ли считать зелёную страницу статуса доказательством работы API?
Нет. Она описывает опубликованное агрегатное состояние. Проверяйте свой запрос с нужным регионом и учётной записью.
Что делать, если status API недоступен?
Отмечайте его состояние как неизвестное и сохраняйте собственный мониторинг. Ошибка status API сама по себе не доказывает падение основного сервиса.
Как не получать две тревоги на один инцидент?
Используйте собственную операцию как основную тревогу, а событие поставщика прикрепляйте как контекст. Группируйте уведомления по времени, компоненту и идентификатору инцидента.